大家好,我是蓝戒。本篇我们来聊聊:“GLM-5.3 vs GLM-5.3-Flash 双雄深度对决”。
最近这一个月,国产大模型圈子里的火药味可以说是浓得呛人。
特别是智谱 AI(Z.ai),一口气连甩两张王牌:
先是在 8 月中旬发布了号称国产开源编程天花板的 GLM-5.3 旗舰版;紧接着又在月底掏出了专为极限降本而生的 GLM-5.3-Flash(代号 Ox-Alpha)。之前蓝戒给大家测评过的神秘模型Ox-Aipha就是它了,感兴趣的朋友可以看这篇文章《免费好用的神秘模型Ox Alpha爆火》。
很多平时用 API 跑代码、做智能体(Agent)的开发者朋友立刻陷入了“选择困难症”:
名字就差了一个“Flash”,价格却差了整整 9 倍!
选贵的吧,生怕当了多花冤枉钱的大冤种;选便宜的吧,又担心便宜没好货,代码写到一半翻车被坑。
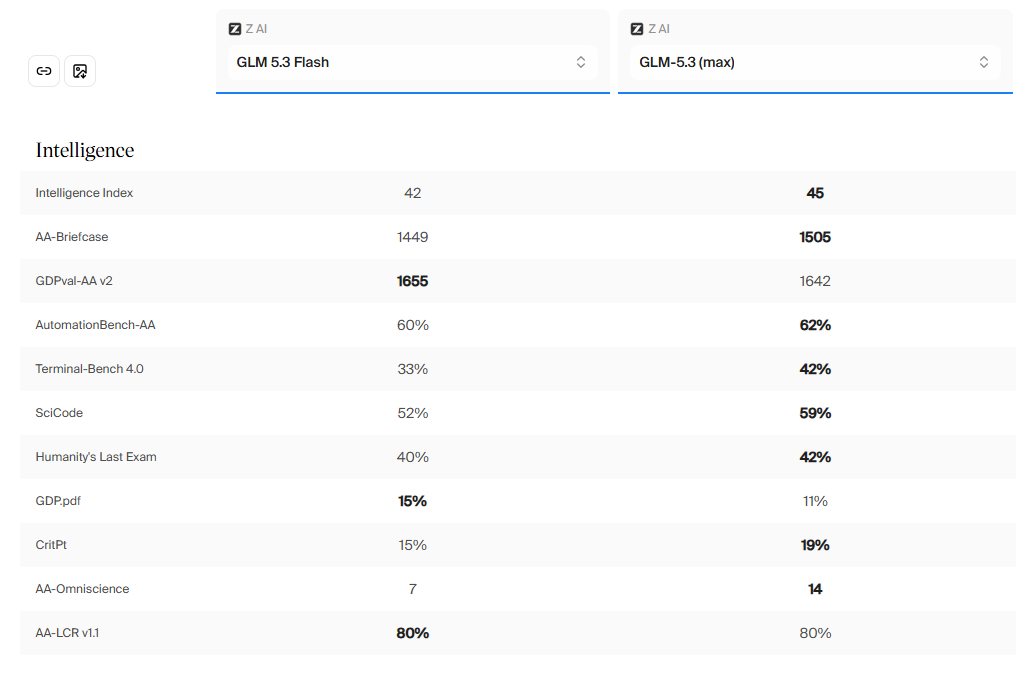
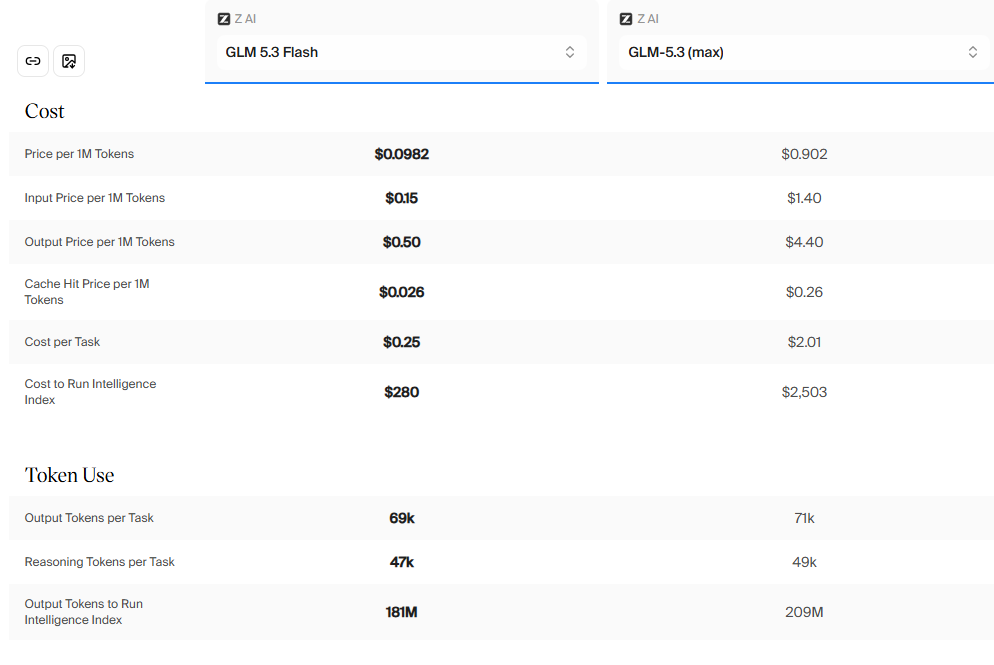
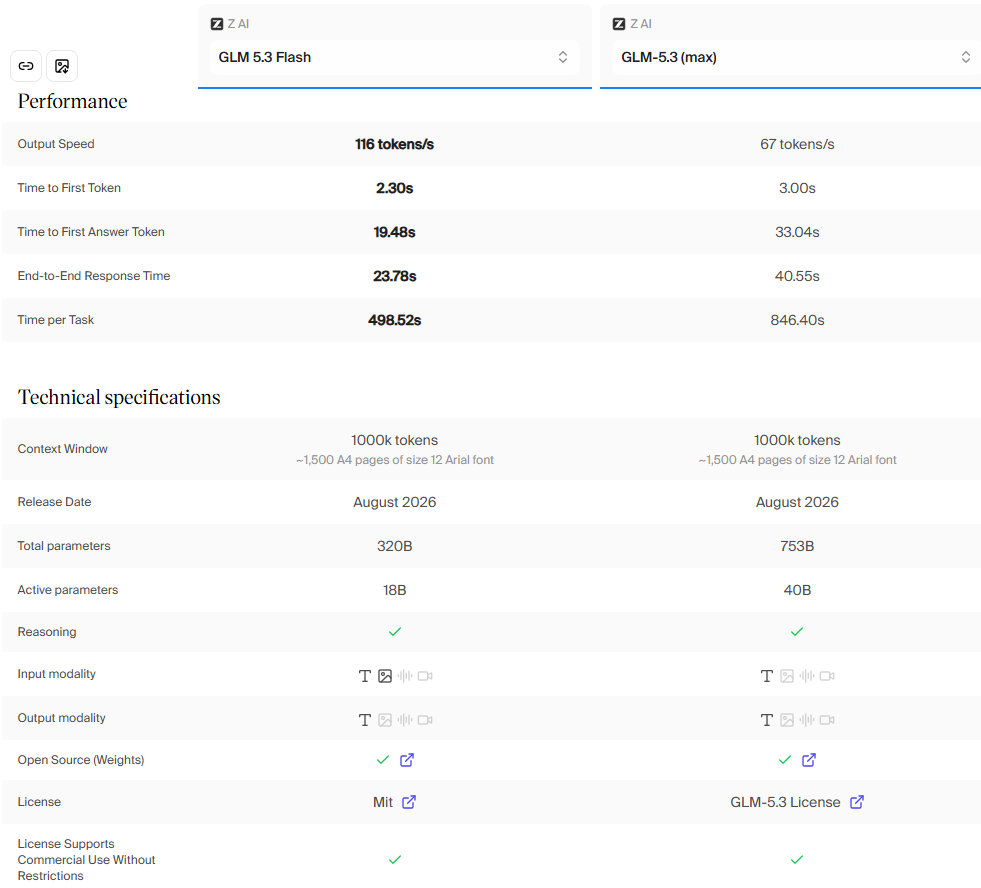
根据权威评测机构 Artificial Analysis 官方模型对比报告 与 Hugging Face 开源主页
的最新实测数据,这两个模型之间藏着一个极度反直觉的行业真相。
今天蓝戒就用最接地气的大白话,帮大家把这两款当红炸子鸡彻底扒个底朝天,教你在实战中把每一分算力都花在刀刃上。
三维硬碰硬:跑分、价格与意想不到的“速度反转”
我们抛开花里胡哨的宣传词,直接来看三个最核心的实操指标:
1. 智商指数:便宜 90%,分数却几乎打平
在权威中立机构评测中,GLM-5.3 旗舰版的综合智能指数拿下了 60 分;而便宜了将近十倍的 GLM-5.3-Flash,竟然拿下了 57 分!双方仅仅相差 3 分!
在考验真实长程软件工程的 DeepSWE 评测中,Flash 模型跑出了 63.4 分,不仅把老一代的 5.2 甩出两条街,更是直接逼平了国外昂贵的顶流闭源模型。
2. 价格账单:真正的降维打击
根据官方计费标准,GLM-5.3-Flash 的调用单价直接打到了骨折:每百万 Token 输入只要几分钱,只有旗舰版的大约九分之一到十分之一。
这意味着同样的预算,调旗舰版只能跑一天,换成 Flash 足够你的自动化智能体不眠不休跑上十天半个月。
3. 意想不到的反转:Flash 居然不是“闪电速度”?
很多人以为叫“Flash”的模型,吐字速度肯定快如闪电。
但实测数据让人大跌眼镜:
- GLM-5.3 旗舰版:每秒输出高达 85 个 Token,真正的大力出奇迹;
- GLM-5.3-Flash:每秒输出大约在 49 到 50 个 Token 上下。
为什么便宜的反而跑得慢?
因为 Flash 采用了创新的混合稀疏注意力机制。它牺牲了一丁点生成速度,换取了显存占用暴降 4.4 倍和极致的低成本。这个反常识的特点,直接决定了它们完全不同的实战阵地。
架构与能力差异:屠龙大砍刀 vs 全能瑞士军刀
我们可以打个非常贴切的现实比方:
GLM-5.3 旗舰版:纯手工锻造的“重型屠龙刀”
它拥有庞大的算力底座,单次计算激活了大约 40B 的庞大参数:
- 火力全开:推演逻辑极其扎实,遇到十几个跨文件的底层架构大重构、复杂的并发死锁,它的表现非常稳重;
- 网络安全专精:在白盒代码审计与高危漏洞排查上拥有极强的杀伤力,适合拿来打最危险的硬仗。
GLM-5.3-Flash:自带眼睛的“高科技瑞士军刀”
总参数虽然高达 320B,但每次只调动 18B 活跃参数。最关键的是,它是一把“原生开了天眼”的军刀:
- 长了眼睛的代码助手:这是 GLM-5 系列首个原生多模态模型。它不需要外挂视觉插件,可以直接用眼睛看你的前端网页截图、看 Blender 3D 渲染图、甚至通过浏览器实时看着界面反馈来改代码;
- 超级抗造的长上下文:支持 100 万超长上下文,由于内部把缓存开销(KV Cache)压到了原来的四分之一,一口气塞进去几十份技术规范,内存依然稳如泰山。
实操指南:究竟该怎么选?
聊完了优缺点,大家最关心的肯定是在具体业务里该翻谁的牌子。蓝戒给大家总结了一份极简选型口诀:
场景一:闭眼直接选 GLM-5.3-Flash(真香首选)
- 写前端与可视化交互:你需要 AI 看着 UI 设计图写页面,或者调试 CSS 样式与 3D 场景;
- 全天候长跑的 Coding Agent:智能体需要高频调用工具、反复检索几万行上下文,Flash 的白菜价能让你彻底告别账单焦虑;
- 日常代码排错与单元测试:绝大多数日常增删改查、逻辑小改动,Flash 的智商完全绰绰有余;
- 独立开发者与中小初创团队:预算有限,想要把钱花在刀刃上。
场景二:果断请出 GLM-5.3 旗舰版(不差钱要极致)
- 底层疑难杂症与架构推演:涉及核心支付流水、高并发系统死锁、多层复杂状态机设计,不允许有一丝闪失;
- 企业级代码安全审计:专门用来扫描线上代码仓库的越权漏洞、注入风险;
- 追求极致吐字速度的高并发接口:业务场景对每秒输出字数(TPS)有严苛要求,需要 85 token/s 的爆发力,一秒钟都不想让用户等待。
思考:国产大模型的“分工艺术”
前两年大家看大模型,总喜欢挑一个“全能冠军”,觉得哪个参数大哪个就天下无敌。
但智谱这次的双雄布局向我们展示了一个成熟生态该有的样子:
没有绝对最好的模型,只有最适合场景的搭配。
把昂贵的重型装甲留给高精尖攻坚,把极致轻量、开了天眼的全能工兵派到日常巡逻一线。
学会把这两种工具打出配合,用不到十分之一的成本撬动顶级大厂同款的工程生产力,这才是 2026 年清醒开发者的生存之道。


文章评论