大家好,我是蓝戒。本篇我们来聊聊:“谷歌发布Gemini4氢模型”。
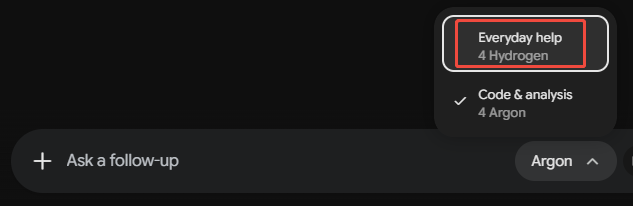
经常在 Google Antigravity、Cursor 或 Google AI Studio 里写代码、搭智能体的朋友,这几天打开模型下拉菜单时肯定注意到了一个重磅变化:
谷歌正式告别了沿用多代的“Flash / Pro”旧命名习惯,全面开启了以“化学元素周期表”命名的 Gemini 4 世代——继主打极限深度推理的重型旗舰 Gemini 4 Carbon(碳) 和先行探路的 Gemini 4 Argon(氩) 之后,就在 11 月 12 日至 15 日,谷歌正式全量推出了整个家族里最走量、最接地气的“高频执行主力”:Gemini 4 Hydrogen(氢,API 标识为 gemini-4-hydrogen)。
作为上一代功勋模型 Gemini 3.8 Flash 的正统接班人,Hydrogen 一出道就演了一出“小弟越级背刺大哥”的好戏:在权威的 Artificial Analysis 全球智力指数榜上,Hydrogen 在默认的 high 思考档位下直接拿到了 51 分(不仅比 3.8 Flash 的 31 分暴涨了 20 分,甚至一举反超了自家几周前才发布的兄长 Gemini 4 Argon 的 50 分!),而在开启新增的 xhigh 档位后更是冲到了 54 分,紧追 Claude Sonnet 5.5(55 分)。
更让全栈开发者心动的是它的速度和账本:任务完成速度比 3.8 Flash 快了整整 2.5 倍,100 万(1M)原生多模态上下文窗口内统一采用扁平计费(输入 $1.50/百万 Token、输出 $7.50/百万 Token,缓存命中仅 $0.075/百万 Token),并且已经正式成为 Google Antigravity 托管智能体的默认底座!
这颗“氢动力引擎”在真实编程和智能体跑批中到底表现如何?新增的四档思考深度该怎么调才不会白花冤枉钱?Antigravity 同步上线的“双模型混搭(Orchestrator)”又是怎么省下四分之一额度的?今天咱们就结合谷歌官方技术报告与第三方安全评测机构 NeuralTrust 的实测数据,把它的长短板一次性拆透。
一、从 3.8 Flash 到 4 Hydrogen:不仅是快了 2.5 倍,而是彻底治好了“原地打转”
很多用过 Gemini 3.8 Flash 跑复杂代码重构的开发者都有过类似的体会:老款 Flash 单次吐字虽然快,但遇到跨十几个文件的复杂 Bug 或者工具调用报错时,容易在同一个死胡同里来回打转重试,最后算下来不仅耗时久,反倒烧掉了更多 Token。
而在 Gemini 4 Hydrogen 上,谷歌 DeepMind 团队针对“智能体实操执行”做了四项脱胎换骨的升级:
- 终端编程能力翻了三倍,学会“并行读文件”:在严苛的终端智能体编程测试
Terminal-Bench 4.1(防作弊校准版)中,3.8 Flash的得分只有 18.2%,而Gemini 4 Hydrogen直接飙升到了 57.0%(暴涨超过 3 倍)!它之所以能在默认档位下实现 2.5 倍的任务提速(企业合作伙伴在复杂图计算与 SQL 工作流中实测提速达 2.0 至 2.8 倍,同时节省 12% 至 23% 的 Token),核心原因在于它改掉了老模型“一个文件接一个文件慢吞吞串行读取”的毛病,原生擅长在单轮里并行打包发起多个文件读取与搜索调用,定位完病灶只做精准的外科手术式修改,绝不乱改无关代码。 - 多项智能体实战基准拿下一席之地:在专门考核在不破坏现有代码前提下排查修复 Bug 的
SWE-sweep测试中,Hydrogen 拿到了 13.5%(大幅领先同价位对手Claude Sonnet 5.5的 3.1% 与GPT-6.1 Terra的 5.8%);在权威的Vals 税务智能体榜(52.3%)与Vals 法律研究榜(55.8%)上双双拿下全场第一;在跨文件多模态知识工作基准MKA(53.4%)和专业工作流Agents' Last Exam v1.1(71.6%)上也稳居同级榜首。 - 100 万上下文“一口价”,输入输出全拉满:很多大模型一旦上下文超过 20 万词元(200K),单价就会直接翻倍。而 Hydrogen 在整个 100 万 Token 的原生多模态窗口(支持同时喂入文本、图片、语音和视频,且最高支持输出达 100 万 Token) 内,全程保持 $1.50 / 百万输入 Token、$7.50 / 百万输出 Token 的统一扁平价格,绝无超长阶梯加价刺客。
- 幻觉率砍掉五分之四,智能体诚实度达 94%:在日常工具调用中,Hydrogen 捏造事实(Fabricated Claims)的概率比上一代降低了 5 倍以上,越权操作(Overreach)减少了 81%,工具误操作减少了 12 倍。在超过 20 万轮内部审计中,它的思维链保持了 99.9% 的清晰可读性,没有任何隐瞒或篡改思考记录的行为,抵御间接提示词注入攻击(Gray Swan IPI 基准)的韧性也提升了 2.3 倍以上。
二、核心玩法拆解:四档思考深度怎么选?Antigravity 的 Orchestrator 有多香?
这次 Gemini 4 Hydrogen 给开发者带来的最大实用改进,就是把推理思考深度拆成了 low、medium、high(默认)与新增的 xhigh 四个可调档位,并在 Google Antigravity 中推出了自动混搭调度器 Orchestrator。
1. 四档思考深度(Thinking Levels)真实开销与选型表
为了帮大家看清不同档位在真实任务里的耗时与金钱账单,我们结合 Artificial Analysis(v5.0.1 榜单)与 Cursor 官方文档的实测数据,整理了下面这张选型表:
| 思考档位 / 对比模型 | AA 全球智力指数得分 | 完成单次复杂评测平均花费 | 单任务平均耗时(首字响应) | 最适合的实战场景与避坑提醒 |
Hydrogen (low 低档) | 27 分 | $0.29 | 极速(亚秒级启动) | 简单意图分类、格式转换、路由分发;切勿用于多文件编程 |
Hydrogen (medium 中档) | 41 分 | $0.80 | 快速 | 常规单文件问答、日常文本提取、轻量表格处理 |
Hydrogen (high 默认高档) | 51 分(反超 Argon) | $1.87(比 3.8 Flash 的 $7.77 省 75%!) | 7.9 分钟(首字 16.7 秒) | 日常编程与智能体黄金甜点档! 兼顾速度、成本与多文件准确率 |
Hydrogen (xhigh 特高档) | 54 分 | $3.16(花费比 high 涨 69%) | 13.7 分钟(首字 40.5 秒) | 疑难杂症深度排错、复杂数学与科学推导;思考极其话痨,按需开启 |
| 对比:Claude Sonnet 5.5 (max) | 55 分 | $10.02 | 34.1 分钟 | 智力仅高 1 分,但单任务花费是 Hydrogen (xhigh) 的 3.1 倍 |
| 对比:Claude Opus 5.5 (max) | 59 分 | $10.04 | 25.2 分钟 | 10 轮缓存编码会话约花 $1.52,而 Hydrogen 仅需 $0.57(省 2.67 倍) |
| 对比:Gemini 4 Carbon (high) | 60 分 | $5.48 | 28.4 分钟 | 谷歌自家重型旗舰,适合当总指挥与 Hydrogen 配合作战 |
看着这张表,你会发现两个非常关键的省钱真相:
- 为什么基础单价涨了,单次任务总账单反而便宜了四分之三?表面上看,Hydrogen 的百万 Token 单价($1.50/$7.50)是
3.8 Flash年底前促销价($0.75/$3.75,明年 1 月 1 日恢复原价)的两倍。但在 Artificial Analysis 的独立实测中,跑完同一套任务,3.8 Flash因为反复出错重试平均要花 $7.77,而聪明的Hydrogen (high)一把过关,平均只花了 $1.87! - 千万别无脑把所有任务都锁死在
xhigh档位!虽然xhigh能把智力分从 51 拉到 54,但第三方实测发现,xhigh在内部思考时是个十足的“话痨”——在整套评测中吐出了高达 3.04 亿个输出 Token(而默认high档只用了 1.1 亿个,行业中位数仅 7280 万个),首字等待时间也拉长到了 40 秒。更重要的是,在标准终端操作Terminal-Bench 4.0上,high和xhigh跑出来的准确率同为 54%!也就是说,普通写代码开xhigh纯属多花 69% 的冤枉钱。正如 Cursor 官方文档所建议的:日常智能体编程请稳稳停在默认的high档,只有遇到连续卡壳的硬核逻辑难题时,再手动切到xhigh攻坚。
2. Google Antigravity 王炸更新:Orchestrator 自动混搭模式
在真实开发里,我们最理想的组合其实是“请顶级架构师画图纸,让手脚麻利的熟练工去施工和跑测试”。
这次谷歌直接在自家的 Google Antigravity 开发环境里上线了全新的 Orchestrator(智能编排器) 模式,并将 Gemini 4 Hydrogen 设为了托管智能体(Managed Agents)的默认引擎:
- 当你发起一个跨模块复杂需求时,Orchestrator 会自动在同一个会话里动态切换 Gemini 4 Carbon 和 Gemini 4 Hydrogen;
- 需要做顶层系统架构设计或解开极其隐蔽的死锁时,由智商 60 分的老大哥
Carbon出面拍板; - 一旦进入具体写代码、跑单元测试、或者拉起多个并行子智能体在隔离工作区里验证修改时,系统瞬间无缝切给速度飞快、价格便宜的
Hydrogen去并行狂飙!
官方实测显示,在 Terminal-Bench 4.0 上,这种“碳氢混搭(Carbon + Hydrogen)”的 Orchestrator 模式,不仅拿到了几乎与全程使用昂贵 Carbon 模型持平的任务成功率,而且平均节省了 24% 的套餐配额,整体完工时间还缩短了 19%!
不仅如此,谷歌还在公告中展示了几个让人眼前一亮的实战案例:在 Antigravity 里搭配全新的前端设计技能(Front-end Design Skill),Hydrogen 仅用一次提示词就生成了带 WebGL2 地形着色器与 3D 线框配置器的完整电商网站;它甚至还能钻进 Google Sheets(谷歌表格) 里,结合 Python 与原生 =LET(...) 公式把几千个单元格变成实时跳动的像素动画画布,或者根据一段演讲视频自动在 Google Slides 里生成多页幻灯片并自己跑一轮“版面重叠检查与自动修字”循环!
三、上手 Gemini 4 Hydrogen 前必看的四个客观边界
最后,结合安全机构 NeuralTrust 的独立审计报告与开发者社区的第一手反馈,我们在把业务切向 Gemini 4 Hydrogen 之前,必须客观认清以下四个现实细节:
- 纯终端与桌面离线操控,Claude Sonnet 5.5 依然握有身位优势:虽然在谷歌公布的 10 项对比基准里,Hydrogen 赢下了其中 7 项(偏重知识综合、图表解析、业务自动化与仓库快速修 Bug),但在最考验纯命令行与桌面点击硬功夫的三项指标——
Terminal-Bench 4.1(57.0% vs 63.9%)、OSWorld-2.1 桌面操作(77.6% vs 83.9%)以及Terminal-Bench-Science(51.4% vs 59.9%)上,Claude Sonnet 5.5依然领先 6 到 8 个百分点。如果你的场景是重度依赖复杂长链条桌面 GUI 点击,Claude 依然略胜一筹;而如果是海量多模态文档处理、数据表格建模与高并发日常编程,Hydrogen 的性价比则呈碾压之势。 - 注意 100 万窗口里的“前台单段输出上限”:虽然总上下文窗口高达 100 万 Token,但据技术媒体 VentureBeat 与文档细节披露,这 100 万容量是由输入、输出、内部思考 Token 与工具调用共同共享的,且单次前台生成段落(Foreground Segment)存在 65,536(64K)Token 的单段上限。在设计超长文本一次性导出流水线时,注意做好分段续写处理。
- 半价“Contributor(贡献者)档位”切勿上传企业涉密数据:在 API 计费中,除了常规的批量异步处理(Batch)和弹性队列(Flex)提供 5 折优惠外,谷歌还提供了一个同样打 5 折且保持标准速度的受邀制 Contributor 档位。但请务必看清条款:使用 Contributor 档位意味着你同意允许谷歌使用该接口的请求数据来改进产品和训练模型!对于涉及金融、医疗或核心商业机密的生产系统,请严格锁定在标准的付费商用层级(Paid Tier)。
- Antigravity 客户端显示“不可用”时的三秒钟解法:目前
Gemini 4 Hydrogen在 Antigravity 中面向 Google AI Pro 与 AI Ultra 付费订阅用户开放。如果你打开客户端发现模型列表里 Hydrogen 依然显示为灰色不可用(Unavailable),只需将客户端升级至最新的 Antigravity App v2.31.2,然后依次点开Settings(设置) > Models(模型)点击刷新按钮即可秒级解锁。
总的来看,Gemini 4 Hydrogen 的全面铺开,补齐了谷歌在“高智商与低成本日常执行”赛道上最重要的一块拼图。当你用着比上一代快 2.5 倍的速度、花着不到竞品三分之一的单任务成本,在 Antigravity 和 AI Studio 里让它带着一群子智能体并行扫平代码库里的报错时,你会真切感受到:属于多模型分工协作的黄金时代,真的已经彻底跑起来了。


文章评论